یک مشاور را تصور کنید که تمرکز اصلیاش روی یک یا دو محله مشخص است. صبح دیوار را باز میکند، چند فایل جدید میبیند، دو سه مورد را برای خودش ذخیره میکند، چند شماره تماس میگیرد و روز بعد تقریباً همین کار را از اول انجام میدهد.
مشکل این نیست که فایل کم است. اتفاقاً فایل زیاد است. مشکل اینجاست که آگهیها تبدیل به یک بانک اطلاعاتی قابل استفاده نمیشوند.
بعد از یک هفته، مشاور یادش نیست کدام فایل را قبلاً دیده، کدام مورد قیمتش تغییر کرده، کدام آگهی دوباره منتشر شده و کدام فایل واقعاً برای مشتریهایش مناسب بوده.
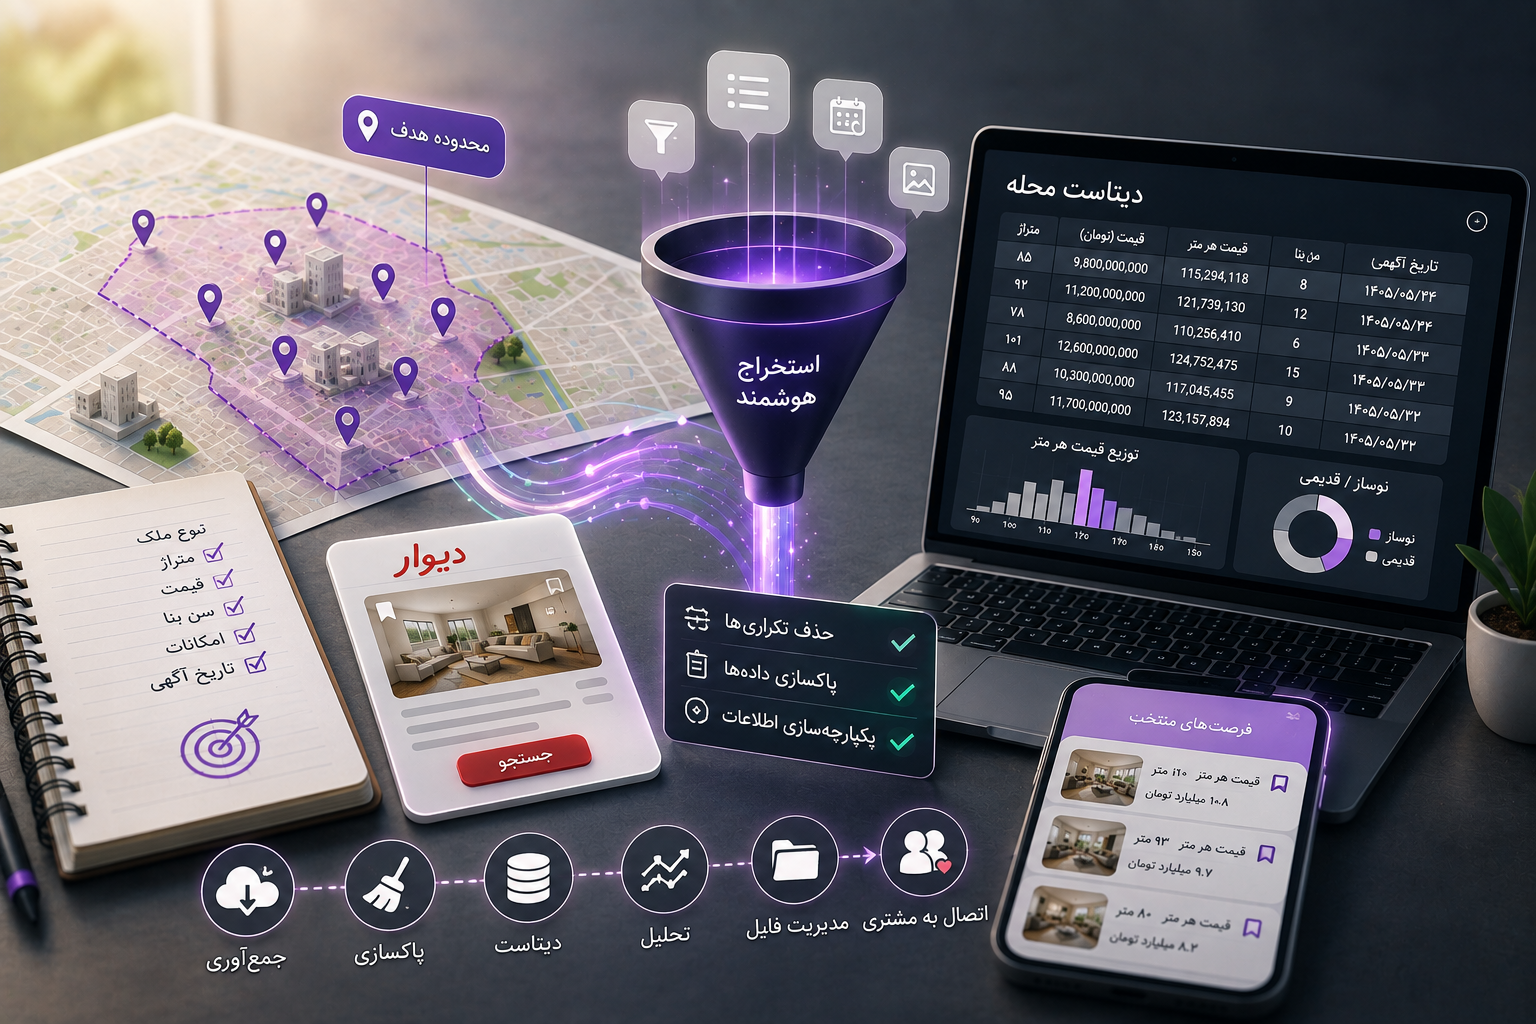
اینجاست که استخراج آگهی دیوار معنی پیدا میکند. هدف فقط دانلود چند لینک نیست؛ هدف این است که آگهیهای یک محدوده را به شکل منظم جمع کنید، اطلاعات مهمشان را استخراج کنید، تکراریها را کنار بگذارید و در نهایت به یک Dataset قابل جستجو و تحلیل برسید.
در این مقاله قدمبهقدم همین مسیر را برای یک محله واقعی بررسی میکنیم؛ از انتخاب محدوده تا جمعآوری فایل، پاکسازی، ساخت بانک فایل، تحلیل قیمت و استفاده در CRM.
استخراج آگهی یک محله یعنی دقیقاً چه؟
وقتی میگوییم استخراج آگهی، منظورمان این نیست که فقط عنوان یا لینک چند آگهی را کپی کنیم.
یک استخراج کاربردی باید اطلاعاتی مثل اینها را تبدیل به داده کند:
- عنوان آگهی
- شهر و محله
- نوع معامله
- نوع ملک
- متراژ
- تعداد اتاق
- سال ساخت
- قیمت کل
- قیمت هر متر
- رهن و اجاره در فایلهای اجارهای
- پارکینگ
- آسانسور
- انباری
- تاریخ انتشار
- لینک آگهی
- شناسه یا Token فایل
وقتی این اطلاعات در یک ساختار واحد قرار بگیرند، دیگر با «آگهی» طرف نیستید؛ با داده بازار کار میکنید.
چرا بهتر است از یک محله شروع کنیم؟
یکی از اشتباههای رایج این است که از روز اول بخواهیم کل یک شهر را جمع کنیم.
روی کاغذ جذاب است: «هرچه فایل بیشتر، بهتر.»
در عمل معمولاً نتیجه برعکس میشود. هزاران فایل دارید ولی وقتی یک مشتری مشخص تماس میگیرد، پیدا کردن فایل مناسب همچنان سخت است.
اگر روی یک یا چند محدوده کاری مشخص تمرکز دارید، بهتر است اول همان بازار کوچک را عمیق بشناسید.
مثلاً به جای:
«همه آپارتمانهای تهران»
میتوانید شروع کنید با:
«فروش آپارتمان ۷۰ تا ۱۲۰ متر در یک محله مشخص، منتشرشده در چند روز اخیر».
این Dataset هم قابل مدیریتتر است و هم برای تماسهای واقعی دفتر کاربرد بیشتری دارد.
مرحله ۱: قبل از استخراج، سؤال خودتان را مشخص کنید
قبل از اینکه دکمهای بزنید یا آگهیای جمع کنید، باید بدانید چرا این داده را میخواهید.
چند هدف مختلف ممکن است داشته باشید:
- ساخت بانک فایل روزانه
- پیدا کردن مالک مستقیم
- پیدا کردن فایل مناسب مشتری
- تحلیل قیمت یک محله
- پیدا کردن فایلهای زیر بازار
- بررسی تغییر قیمتها در طول زمان
هر هدف، فیلتر و داده متفاوتی میخواهد.
اگر هدفتان تحلیل قیمت فروش است، قیمت کل، متراژ، قیمت هر متر، سن بنا و محدوده اهمیت بیشتری دارند.
اگر هدفتان فایلینگ روزانه است، شماره تماس، تازگی فایل، وضعیت مالک و تطبیق با مشتری مهمتر میشوند.
مرحله ۲: محدوده را دقیق انتخاب کنید
در استخراج محلهای، فیلتر جغرافیایی یکی از مهمترین بخشهاست.
اگر محدوده بیش از حد بزرگ باشد، دادهها ناهمگن میشوند. اگر خیلی کوچک باشد، ممکن است تعداد فایل کافی نداشته باشید.
یک روش عملی این است که ابتدا با خود محله شروع کنید و بعد اگر حجم فایل بالا بود، آن را به زیرمحدودههای کاری تقسیم کنید.
مثلاً ممکن است در یک محله متوجه شوید:
- سمت شمالی بیشتر نوساز است
- یک خیابان اصلی فایلهای گرانتری دارد
- بخش دیگری بیشتر واحدهای کوچک دارد
وقتی داده را روی نقشه ببینید، این تفاوتها خیلی واضحتر میشوند. برای همین مقاله تحلیل محله روی نقشه میتواند ادامه خوبی برای این موضوع باشد.
مرحله ۳: فیلترها را از اول درست بچینید
اگر هر چیزی را وارد Dataset کنید، بعداً باید زمان زیادی صرف پاکسازی کنید.
قبل از جمعآوری، حداقل این موارد را مشخص کنید:
- نوع معامله: فروش، رهن یا اجاره
- نوع ملک: آپارتمان، خانه، زمین و ...
- محدوده متراژ
- بازه قیمت در صورت نیاز
- سن بنا در صورت مرتبط بودن
- محله یا محدوده جغرافیایی
هرچه ورودی تمیزتر باشد، خروجی مفیدتر است.
استخراج دستی بهتر است یا خودکار؟
بستگی به حجم کارتان دارد.
| روش | مناسب برای | محدودیت |
|---|---|---|
| ثبت دستی | حجم کم و تست اولیه | زمانبر و مستعد خطا |
| اکسل دستی | بانک فایل کوچک | بهروزرسانی و dedup دشوارتر |
| استخراج خودکار | کار روزانه و تعداد بیشتر آگهی | نیاز به ابزار و فرآیند مشخص |
اگر فقط میخواهید برای یک مشتری ۱۰ فایل جمع کنید، احتمالاً روش دستی کافی است.
ولی اگر قرار است هر روز دهها یا صدها آگهی را برای چند محله بررسی کنید، فرآیند دستی خیلی زود تبدیل به کار تکراری میشود.
برای مقایسه دقیقتر این دو روش، مقاله استخراج دستی یا ربات دیوار؟ را ببینید.
مرحله ۴: فقط اطلاعاتی را جمع کنید که بعداً استفاده میکنید
جمعآوری داده بیشتر همیشه بهتر نیست.
اگر ۴۰ ستون دارید ولی در عمل فقط ۱۲ ستون استفاده میشوند، Dataset شلوغ و نگهداری سختتر میشود.
برای فایلینگ روزانه فروش آپارتمان، یک ساختار کاربردی میتواند این باشد:
| فیلد | کاربرد |
|---|---|
| عنوان | شناخت سریع فایل |
| محله | فیلتر جغرافیایی |
| متراژ | تطبیق با مشتری و تحلیل |
| قیمت کل | بودجه مشتری |
| قیمت هر متر | مقایسه بازار |
| سن بنا | Comparable و نیاز مشتری |
| امکانات | فیلتر پارکینگ، آسانسور و ... |
| لینک | برگشت به منبع اصلی |
| تاریخ | تشخیص تازگی |
یک سناریوی واقعی: ۱۸۰ آگهی دارید، ولی فقط ۹۰ فایل واقعی
فرض کنید از یک محدوده در چند روز ۱۸۰ آگهی جمع کردهاید.
اول فکر میکنید بازار خیلی پرعرضه است.
اما وقتی داده را پاکسازی میکنید، متوجه میشوید:
- ۳۶ آگهی تکراریاند
- ۲۱ مورد مربوط به همان ملک با قیمت متفاوت هستند
- ۱۲ مورد اصلاً مربوط به محدوده هدف نیستند
- ۹ مورد اطلاعات ناقص دارند
در نهایت چیزی حدود ۱۰۰ فایل قابل استفاده باقی میماند.
این اختلاف خیلی مهم است. اگر با همان ۱۸۰ ردیف تحلیل قیمت انجام دهید، ممکن است نتیجه اشتباه شود.
مرحله ۵: Duplicate را جدی بگیرید
یک ملک میتواند چند بار ظاهر شود:
- توسط مالک
- توسط چند مشاور
- با قیمت جدید
- با عنوان جدید
اگر Dataset قرار است برای تحلیل استفاده شود، تکراریها باید مشخص شوند.
نشانههای مهم:
- Token یا شناسه یکسان
- شماره تماس یکسان
- متراژ و مشخصات یکسان
- عکسهای مشابه
- قیمت و آدرس نزدیک
برای این بخش، راهنمای حذف آگهی تکراری در فایلینگ را حتماً ببینید.
آگهی تکراری همیشه باید حذف شود؟
نه لزوماً.
اگر هدف فقط ساخت لیست فایلهای یکتا باشد، بله؛ بهتر است Merge شود.
اما اگر میخواهید تغییر قیمت را رصد کنید، نسخه قدیمی یک آگهی میتواند خودش اطلاعات ارزشمندی باشد.
مثلاً:
- روز اول: ۱۲.۸ میلیارد
- روز دهم: ۱۲.۳ میلیارد
- روز بیستم: ۱۱.۹ میلیارد
در چنین حالتی شاید یک ملک داشته باشید، ولی سه Snapshot ارزشمند از رفتار قیمت دارید.
مرحله ۶: مالک، مشاور یا نامشخص؟
برای خیلی از مشاورها این یکی از مهمترین خروجیهاست.
ممکن است بخواهید بدانید کدام آگهی احتمال بیشتری دارد که مستقیم توسط مالک ثبت شده باشد.
اما این موضوع باید با احتیاط تحلیل شود. هیچ نشانه واحدی همیشه قطعی نیست.
متن آگهی، تعداد فایلهای مشابه، نحوه معرفی ملک و الگوهای تماس میتوانند سرنخ بدهند، ولی نتیجه بهتر است به شکل احتمال دیده شود، نه حکم قطعی.
راهنمای تشخیص مالک واقعی دیوار این موضوع را مفصلتر توضیح میدهد.
مرحله ۷: Dataset را برای کار واقعی آماده کنید
بعد از استخراج و پاکسازی، داده باید قابل استفاده باشد.
یعنی بتوانید سریع فیلتر کنید:
- ۸۰ تا ۱۰۰ متر
- زیر یک بودجه مشخص
- دارای پارکینگ
- زیر ۱۰ سال ساخت
- منتشرشده در چند روز اخیر
اگر هنوز برای پیدا کردن این فایلها مجبورید تکتک ردیفها را بخوانید، Dataset بهاندازه کافی ساختاریافته نیست.
از Dataset به تحلیل بازار برسید
اینجا همان نقطهای است که استخراج از یک کار مکانیکی تبدیل به ابزار تصمیمگیری میشود.
با یک Dataset تمیز میتوانید بررسی کنید:
- میانه قیمت هر متر چقدر است
- بازه پرتکرار قیمت چیست
- کدام متراژها عرضه بیشتری دارند
- نوسازها چقدر با قدیمیها اختلاف دارند
- چه تعداد فایل زیر بازار دیده میشوند
برای این مرحله مقاله تحلیل آگهیهای دیوار برای قیمتگذاری ملک ادامه مستقیم همین مسیر است.
مثال: از ۲۴۰ فایل خام تا تحلیل یک محله
فرض کنید برای یک محله ۲۴۰ آگهی فروش آپارتمان جمع کردهاید.
بعد از پاکسازی نتیجه این شده:
| مرحله | تعداد فایل |
|---|---|
| آگهی خام | ۲۴۰ |
| بعد از حذف محدوده نامرتبط | ۲۱۸ |
| بعد از حذف یا Merge تکراری | ۱۷۴ |
| دارای قیمت و متراژ معتبر | ۱۵۹ |
| گروه هدف ۷۰ تا ۱۱۰ متر | ۹۶ |
حالا به جای ۲۴۰ آگهی پراکنده، ۹۶ فایل دارید که واقعاً برای سؤال شما مرتبطاند.
این تفاوت بین «حجم داده» و «داده مفید» است.
چطور فایلهای مناسب مشتری را از همین Dataset پیدا کنیم؟
فرض کنید مشتری شما دنبال این مشخصات است:
- حدود ۸۵ تا ۱۰۰ متر
- دو خواب
- پارکینگ ضروری
- سن زیر ۱۵ سال
- بودجه محدود
به جای اینکه دوباره وارد دیوار شوید و جستجو را از صفر شروع کنید، روی Dataset فیلتر میزنید.
از ۹۶ فایل شاید فقط ۱۳ مورد باقی بماند.
بعد میتوانید همان ۱۳ فایل را دقیقتر بررسی کنید و بهترین ۳ تا ۵ مورد را برای مشتری بفرستید.
این همان نقطهای است که بانک فایل واقعاً زمان مشاور را ذخیره میکند.
استخراج بدون CRM نصفهکاره است
فرض کنید ۵۰۰ فایل عالی دارید، ولی نمیدانید کدام مشتری دنبال کدام فایل است.
این یعنی بخش دوم جریان کار هنوز کامل نشده.
بانک فایل باید به نیاز مشتری وصل شود.
وقتی مشتری ثبت شده باشد و معیارهایش مشخص باشند، میتوانید فایلهای مناسب را سریعتر پیدا کنید و پیگیری بعدی را هم ثبت کنید.
اینجا فایلینگ و CRM مکمل یکدیگر میشوند؛ یکی ملک را مدیریت میکند، دیگری مشتری را.
تازگی داده چقدر مهم است؟
خیلی زیاد.
بانک فایل قدیمی ممکن است از نظر تعداد بزرگ باشد، ولی برای تماس امروز ارزش کمی داشته باشد.
برای همین بهتر است هر فایل حداقل تاریخ جمعآوری یا تاریخ انتشار داشته باشد.
یک ساختار ساده:
- فایل تازه
- فایل نیازمند بررسی
- فایل قدیمی
- فایل غیرفعال
این وضعیتها کمک میکنند بانک فایل بعد از چند هفته به انبار اطلاعات مرده تبدیل نشود.
آیا هر روز باید همه آگهیها را دوباره استخراج کنیم؟
نه لزوماً.
اگر فرآیند درست طراحی شود، هدف این است که فایلهای جدید و تغییرات مهم را بگیرید، نه اینکه هر بار همه چیز را از صفر بازسازی کنید.
مثلاً میتوانید:
- فایلهای جدید را اضافه کنید
- قیمت فایلهای قبلی را بهروزرسانی کنید
- آگهیهای حذفشده یا منقضی را علامت بزنید
یک ریتم کاربردی برای مشاور محلهای
| زمان | کار |
|---|---|
| روزانه | افزودن فایلهای جدید و بررسی موارد مهم |
| هر چند روز | بررسی تغییر قیمت و وضعیت فایلها |
| هفتگی | پاکسازی Duplicate و فایلهای مرده |
| هفتگی یا ماهانه | تحلیل Dataset و مقایسه بازار |
Compare Dataset چه زمانی مفید میشود؟
فرض کنید همین هفته ۱۵۰ فایل معتبر دارید.
هفته بعد دوباره از همان محدوده داده میگیرید.
اگر فقط Dataset جدید را ببینید، وضعیت امروز را میفهمید. اما اگر هر دو را مقایسه کنید، میتوانید تغییر را ببینید:
- چه فایلهایی جدید آمدهاند
- کدام فایلها حذف شدهاند
- چه قیمتهایی تغییر کردهاند
- میانه بازار چقدر جابهجا شده
برای این کار مقاله Compare Dataset: چطور تغییرات بازار محله را رصد کنیم؟ را ببینید.
اشتباهات رایج در استخراج آگهی دیوار
- جمع کردن همهچیز: حجم بالا بدون هدف فقط بانک فایل را شلوغ میکند.
- نداشتن محدوده مشخص: داده ناهمگن میشود.
- ذخیره نکردن شناسه فایل: تشخیص تکراری سختتر میشود.
- بیتوجهی به تاریخ: فایل قدیمی و جدید قاطی میشوند.
- تحلیل قبل از پاکسازی: Duplicateها نتیجه را خراب میکنند.
- اعتماد کامل به تعداد فایل: ۲۰۰ آگهی لزوماً ۲۰۰ ملک نیست.
- جدا نکردن هدف استخراج: Dataset تحلیلی با بانک فایل تماس یکی نیست.
- بهروزرسانی نکردن: بانک فایل خیلی زود بیارزش میشود.
استخراج قانونی و مسئولانه یعنی چه؟
هر ابزاری که برای جمعآوری داده از یک سرویس آنلاین استفاده میکنید باید با قوانین، محدودیتهای فنی و شرایط استفاده همان سرویس هماهنگ باشد.
هدف یک فرآیند حرفهای نباید ایجاد فشار غیرضروری روی سرویس، دور زدن محدودیتهای امنیتی یا استفاده نامناسب از اطلاعات افراد باشد.
برای کار روزمره، دادههایی را جمع کنید که واقعاً برای فایلینگ و تحلیل نیاز دارید و از آنها در چهارچوب حرفهای و مسئولانه استفاده کنید.
ربات استخراج دیوار چه زمانی ارزش دارد؟
اگر هفتهای چند فایل محدود بررسی میکنید، احتمالاً نه.
ولی وقتی:
- چند محله دارید
- روزانه فایل زیادی بررسی میکنید
- مرتب Dataset میسازید
- نیاز به خروجی ساختاریافته دارید
آن وقت خودکارسازی میتواند مقدار زیادی از کار تکراری را کم کند.
اگر میخواهید درباره هزینه و بازگشت سرمایه این ابزارها تصمیم بگیرید، مقاله قیمت ربات استخراج دیوار و محاسبه ROI را هم ببینید.
یک Workflow واقعی از دیوار تا مشتری
اگر بخواهیم کل فرآیند را خیلی خلاصه کنیم، یک مسیر حرفهای میتواند این باشد:
- انتخاب محله و فیلتر
- جمعآوری آگهیها
- ساخت Dataset
- حذف تکراری و پاکسازی
- شناسایی فایلهای مهم
- تحلیل قیمت
- تطبیق با مشتریهای CRM
- پیگیری تماس و بازدید
این مسیر خیلی متفاوت است با اینکه فقط هر روز دیوار را باز کنیم و چند آگهی جدید ببینیم.
در فایلینگ دیوار میتوانید آگهیها را به Dataset تبدیل کنید، فایلهای تکراری را پاکسازی کنید، قیمتها را تحلیل کنید و فایلهای مناسب را سریعتر به مشتریهای CRM وصل کنید.
بررسی ابزارهای فایلینگ و Datasetجمعبندی؛ استخراج خوب یعنی دادهای که فردا هم به درد بخورد
استخراج آگهی دیوار فقط جمع کردن تعداد زیادی لینک نیست.
اگر خروجی قرار است برای کار واقعی مشاور ارزش داشته باشد، باید:
- هدف مشخص داشته باشد
- محدوده درست انتخاب شود
- فیلترهای مرتبط اعمال شوند
- داده ساختاریافته جمع شود
- تکراریها پاکسازی شوند
- فایلهای قدیمی مدیریت شوند
- Dataset به تحلیل و CRM وصل شود
وقتی این زنجیره درست باشد، نتیجه دیگر یک پوشه پر از آگهی نیست؛ یک بانک فایل زنده و قابل استفاده است.
یعنی وقتی مشتری تماس میگیرد، به جای اینکه تازه دیوار را باز کنید، از قبل میدانید چه فایلهایی دارید، کدامها تازهاند و کدام مورد به نیاز او نزدیکتر است.
مطالب مرتبط: راهنمای کامل استخراج آگهی دیوار · حذف آگهیهای تکراری · تحلیل آگهیها برای قیمتگذاری
سوالات متداول درباره استخراج آگهیهای دیوار
استخراج آگهی دیوار یعنی چه؟
یعنی اطلاعات مهم آگهیها مانند محله، متراژ، قیمت، سن بنا، امکانات، تاریخ و لینک را به شکل ساختاریافته جمع کنیم تا بتوان آنها را جستجو، فیلتر، پاکسازی و تحلیل کرد.
برای شروع بهتر است کل شهر را استخراج کنیم یا یک محله؟
برای بیشتر مشاورها شروع از یک یا چند محله اصلی بهتر است. Dataset محدودتر هم قابل مدیریتتر است و هم برای تماسها، قیمتگذاری و شناخت بازار محلی کاربرد بیشتری دارد.
استخراج دستی بهتر است یا ربات دیوار؟
برای چند فایل محدود روش دستی کافی است. اگر روزانه با حجم بالاتری از آگهیها، چند محله یا Datasetهای دورهای کار میکنید، خودکارسازی میتواند کار تکراری را کاهش دهد.
چه اطلاعاتی از هر آگهی باید ذخیره شود؟
حداقل محله، متراژ، قیمت کل، قیمت هر متر، سن بنا، امکانات اصلی، تاریخ انتشار، لینک آگهی و یک شناسه مناسب برای تشخیص تکراریها مفید است.
چرا حذف آگهیهای تکراری مهم است؟
چون یک ملک ممکن است چند بار آگهی شود. اگر همه نسخهها را ملکهای مستقل در نظر بگیریم، تعداد فایل و تحلیل قیمت بازار میتواند اشتباه شود.
Dataset املاک چه تفاوتی با ذخیره لینک آگهی دارد؟
در Dataset اطلاعات اصلی هر آگهی به ستونهای قابل فیلتر و تحلیل تبدیل میشوند. به همین دلیل میتوان قیمت، متراژ، سن و سایر ویژگیها را بدون باز کردن تکتک لینکها مقایسه کرد.
آیا Dataset قدیمی هنوز کاربرد دارد؟
برای فایلینگ روزانه، داده تازه ارزش بیشتری دارد؛ اما Datasetهای قدیمی برای بررسی تغییر قیمت، روند عرضه و مقایسه دورههای مختلف بازار بسیار مفید هستند.
بعد از استخراج آگهیها چه کاری انجام دهیم؟
دادهها را پاکسازی کنید، تکراریها را مشخص کنید، فایلها را بر اساس نیاز کاری دستهبندی کنید و سپس از Dataset برای تحلیل قیمت، پیدا کردن فایل مناسب و تطبیق با مشتریهای CRM استفاده کنید.
