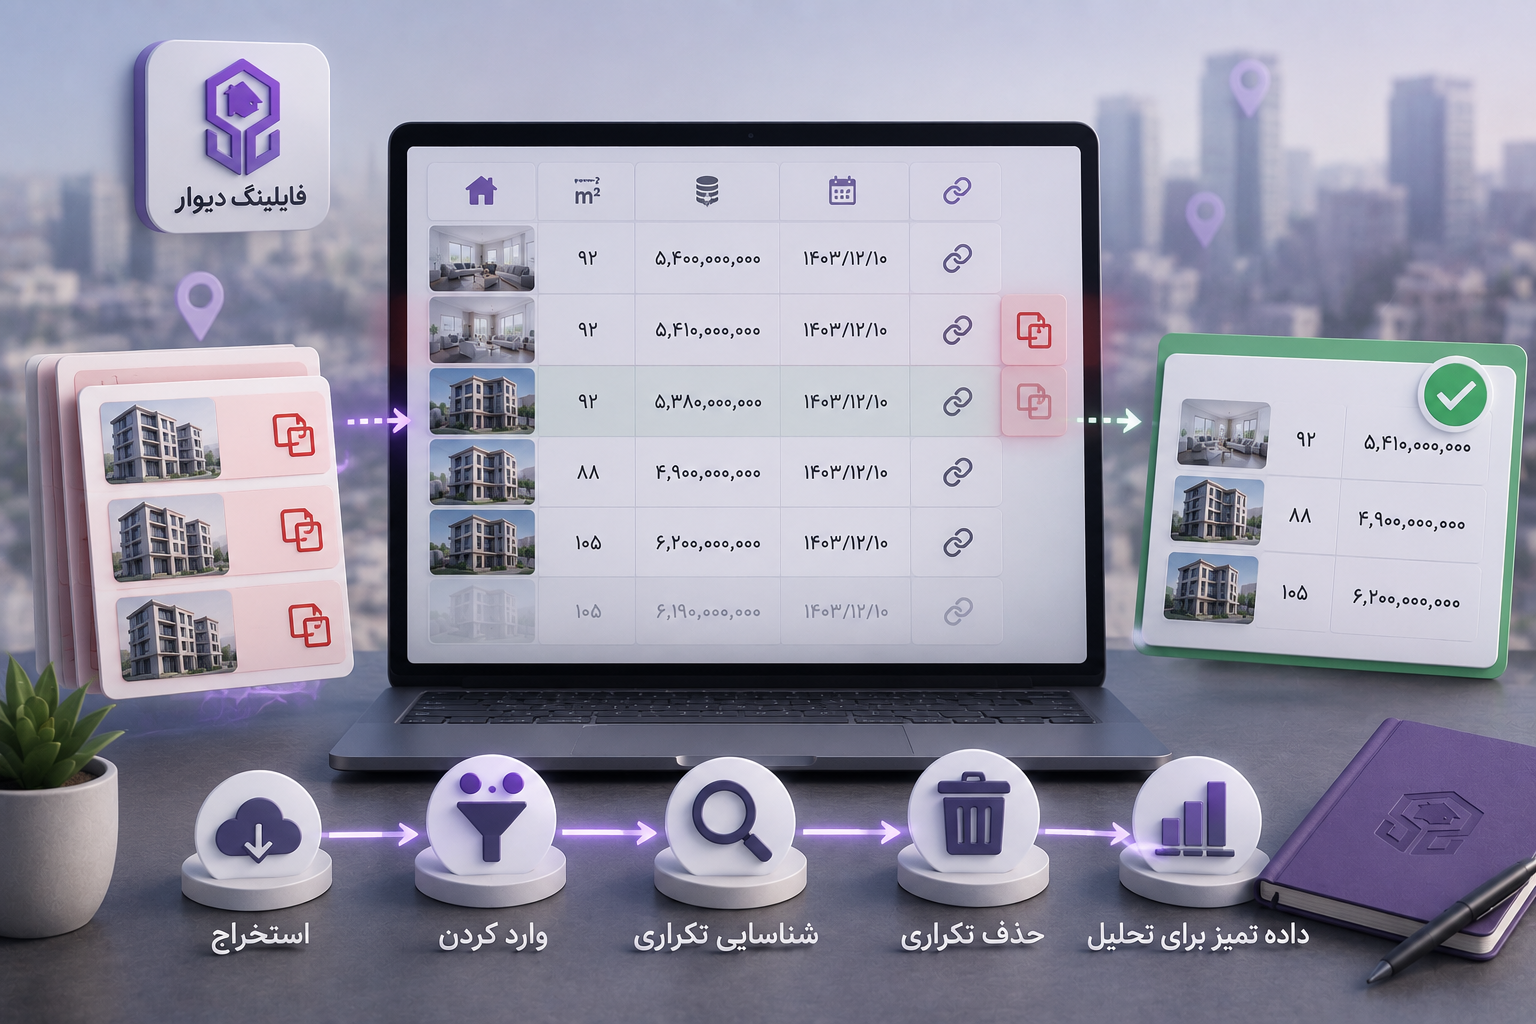
Dataset ۲۰۰ تایی import کردید؛ Analyze میانه ۵۲ میلیون نشان میدهد. مشتری میگوید «غلط است — من ارزانتر دیدم». نگاه میکنید: همان آپارتمان ۳ بار با قیمتهای مختلف در لیست است. یا Compare میگوید «۵۰ فایل جدید» در حالی که ۴۰ تایشان duplicate هستند.
حذف آگهی تکراری در فایلینگ کار unsexy اما حیاتی است — پایه تحلیل بازار، Compare Dataset و گزارش قیمت مالک. بدون پاکسازی، تحلیل بازار و قیمتگذاری روی داده کثیف ساخته میشود.
این راهنما بعد از استخراج دیوار و قبل از Analyze میآید — بخشی از فایلینگ املاک و سازماندهی آگهی.
بعد هر import: sort/token → ابزار duplicate میزکار → نگهداشتن جدیدترین قیمت → حذف پرت → Analyze sanity check. زمان: ۱۰–۱۵ دقیقه. قبل Compare حتماً duplicate = ۰.
تکراری یعنی چه — انواع duplicate
| نوع | علت | خطر | راهحل |
|---|---|---|---|
| Token یکسان | Import دوباره همان Export | میانه artificial | Merge / حذف |
| Append بدون Compare | Export روی Dataset قدیمی | تعداد inflated | Dataset هفتگی جدا |
| ملک یکسان، چند token | مالک + مشاور هر دو آگهی | double-count در Analyze | قضاوت — یک ردیف برای Analyze |
| کپی همکار | لینک یکسان در Datasetهای مختلف | گاهی OK در CRM | برچسب منبع |
| Excel چند فایل | export(1), export(2) merge | هرجومرج | نامگذاری + یک مسئول import |
چرا duplicate برای مشاور خطرناک است؟
| بدون پاکسازی | Dataset تمیز |
|---|---|
| میانه قیمت غلط | میانه نزدیک بازار دیوار |
| Compare fake «جدید» | Delta واقعی |
| ۳ بار همان فایل برای مشتری | اعتبار حرفهای |
| عمق بازار inflated | «۸۷ فایل» = ۸۷ ملک |
| گزارش مالک قابل حمله | گزارش دفاعپذیر |
ارتباط با ۷ اشتباه قیمتگذاری: «Dataset بزرگ = بهتر» بدون پاکسازی یکی از بدترینهاست.
فرآیند پاکسازی — ۶ مرحله
۱. Sort بر اساس token / لینک
duplicate واضح کنار هم دیده میشود. لینک آگهی دیوار معمولاً token یکتا دارد.
۲. ابزار duplicate میزکار
در فایلینگ دیوار duplicate token شناسایی و merge یا حذف. نگه دارید: جدیدترین Export و کاملترین فیلد.
۳. ملک یکسان — دو token (سختتر)
متراژ + محله + طبقه + قیمت نزدیک — قضاوت انسانی. برای Analyze یک ردیف؛ برای CRM هر دو با برچسب «منبع: مالک / مشاور».
۴. حذف پرت
قیمت/متراژ غیرمنطقی — تحلیل قیمت و پرت.
۵. Sanity check Analyze
تعداد و میانه با «حس بازار» جور درمیآید؟
۶. ثبت نسخه نهایی
یادداشت: «W12 — ۸۷ فایل پس از duplicate» — برای Compare.
Import → duplicate → Analyze — ۱۵ دقیقه.
قوانین نگهداشتن یک ردیف از چند duplicate
- جدیدترین تاریخ Export
- قیمت بهروز — اگر یکی تغییر کرده
- کاملترین ستونها (طبقه، پارکینگ، …)
- یادداشت: «dup حذف — نگه W12»
پاکسازی در زنجیره کار
- استخراج
- پاکسازی duplicate (همین مطلب)
- Analyze
- Compare
- گزارش
- CRM روزانه
Compare فقط با Dataset تمیز
Compare دو Dataset کثیف = «۱۰۰ فایل جدید» که نصفشان duplicate. قوانین:
- هر دو Dataset duplicate-free
- فیلتر یکسان (متراژ، نوع، محله)
- نام هفته واضح
پیشگیری — import درست
- Dataset هفتگی جدید — نه overwrite بینام
- یک مسئول import در آژانس — مدیریت تیم
- Export کامل محله — ربات — نه patch قاطی
- قبل merge به Dataset اصلی، Compare — import
- استاندارد نام: «[محله] — [نوع] — WXX» — بانک فایل
برنامه هفتگی پاکسازی
| قدم | کار | زمان | ابزار |
|---|---|---|---|
| ۱ | Import Export جدید | ۵ دقیق | ربات / Excel |
| ۲ | Duplicate token | ۵ دقیق | میزکار duplicate |
| ۳ | حذف پرت | ۳ دقیق | فیلتر + چشم |
| ۴ | Analyze + ثبت N نهایی | ۲ دقیق | Analyze |
| ۵ | Compare با هفته قبل | ۵ دقیق | Compare |
جمع: ~۲۰ دقیقه — بخشی از فایلینگ هوشمند و فایلینگ خودکار.
تکراری vs دو منبع — CRM vs Analyze
| سناریو | برای Analyze | برای CRM |
|---|---|---|
| مالک + مشاور، یک ملک | یک ردیف (میانه) | دو لینک + برچسب منبع |
| همان token دوبار import | حذف قطعی | — |
| قیمتهای مختلف، token یکسان | جدیدترین | تاریخچه در یادداشت |
مثال واقعی: قبل و بعد پاکسازی
قبل: ۱۴۲ ردیف import — Analyze median 51M/m — مالک شک میکند.
بعد duplicate + پرت: ۱۱۸ ردیف — median 46M/m — با ۳ comparable مالک قبول کرد.
زمان پاکسازی: ۱۲ دقیقه.
درس: ۲۴ ردیف اضافه میانه را ~۱۰٪ بالا برده بود.
مثال ۲: Compare غلط
Compare بدون پاکسازی: «+۴۵ جدید». بعد duplicate: «+۶ جدید، ۳۹ duplicate import اشتباه». گزارش به تیم: استاندارد import — سازماندهی.
اشتباهات رایج
- Skip پاکسازی — «بعداً» = never
- حذف تصادفی unique — sort قبل delete
- Dataset ۱۰ هزار تایی بدون پاکسازی
- Compare قبل duplicate
- فقط Excel روی دسکتاپ — بدون ابزار duplicate
- ارسال comparable بدون چک لینک — مقایسه
چکلیست Dataset آماده
- Duplicate token = ۰ (یا merge)
- پرتهای شدید حذف
- N نهایی در Analyze ثبت
- نام Dataset + تاریخ/هفته
- Compare همفیلتر با هفته قبل
- آماده گزارش مالک
مدیر آژانس: SOP پاکسازی
یک صفحه SOP برای تیم: نام Dataset، duplicate، مسئول، KPI «هیچ Analyze بدون duplicate check». Dataset مشترک — مدیریت آژانس.
ملاحظات
- پاکسازی روی داده عمومی دیوار — رعایت terms
- حذف duplicate ≠ حذف آگهی از دیوار — فقط در Dataset شما
مطالب مرتبط
جمعبندی
حذف آگهی تکراری پایه تحلیل درست است. ۱۰–۱۵ دقیقه بعد هر import — گزارشی که مالک باور کند و Compareی که به دروغ «+delta» نگوید.
نویسنده: حسین قشقایی — فایلینگ دیوار.
سوالات متداول
چطور duplicate را سریع پیدا کنم؟
Sort token/لینک؛ ابزار duplicate میزکار.
دو قیمت برای یک token؟
جدیدترین Export را نگه دارید.
هر import پاکسازی لازم است؟
بله — حداقل duplicate check.
بدون ربات؟
Excel — sort و حذف دستی؛ کندتر.
duplicate Analyze را چقدر خراب میکند؟
بسته به درصد — گاهی ۵–۱۵٪ خطا در میانه.
CRM جدا از Analyze؟
بله — دو منبع یک ملک در CRM OK؛ Analyze یک ردیف.
ابزار duplicate رایگان است؟
در میزکار فایلینگ — CRM رایگان؛ جزئیات اینجا.