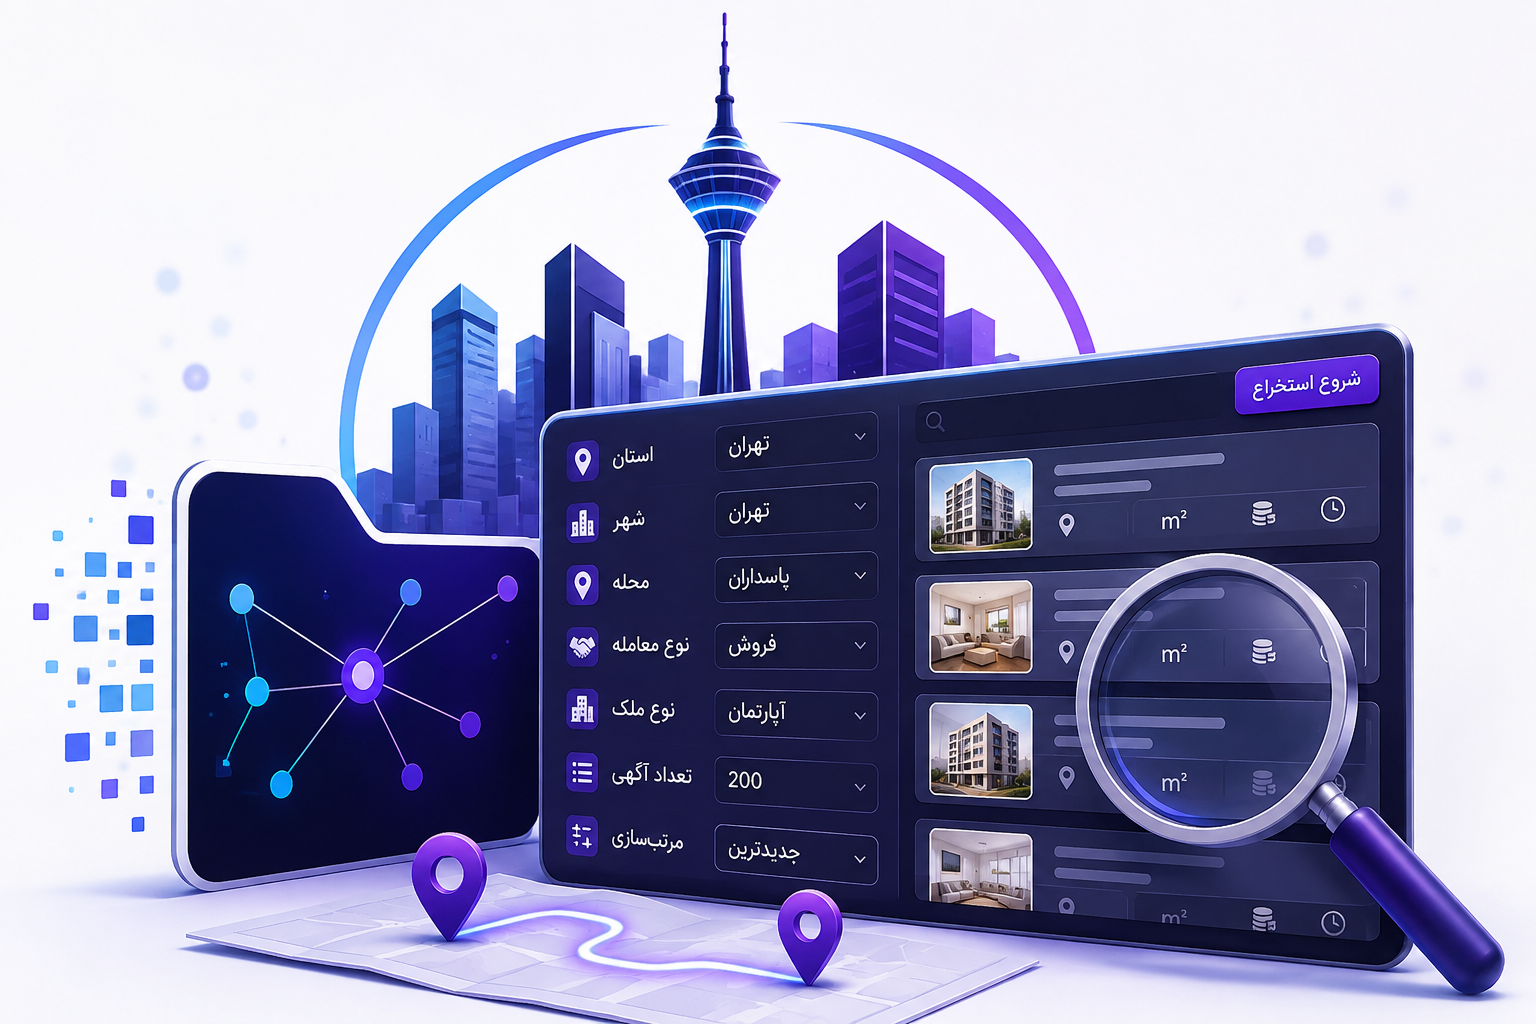
یکی از رایجترین اشتباهها بعد از نصب ربات استخراج دیوار این است که کاربر فکر میکند هرچه آگهی بیشتری بگیرد، نتیجه بهتری خواهد داشت.
مثلاً ربات را باز میکند، محدوده بزرگی انتخاب میکند، چند دسته ملکی را با هم میزند و تعداد آگهی را تا جای ممکن بالا میبرد.
چند ساعت بعد یک فایل بزرگ دارد.
اما وقتی مشتری تماس میگیرد و میگوید:
«آپارتمان دوخواب، حدود ۹۰ متر، پارکینگدار و در دو محله مشخص میخوام.»
همان سؤال قدیمی دوباره برمیگردد:
از بین این همه فایل، کدامها واقعاً به درد این مشتری میخورند؟
اینجاست که میفهمیم کیفیت استخراج از تعداد خروجی مهمتر است.
ربات استخراج زمانی بیشترین ارزش را دارد که قبل از زدن دکمه شروع، دقیق بدانید دنبال چه بازاری هستید.
در این مقاله میخواهیم قدمبهقدم تنظیمات و منطق فیلتر را بررسی کنیم؛ از استان، شهر و محله گرفته تا نوع معامله، دسته ملک، تعداد آگهی و مرتبسازی.
هدف این نیست که صرفاً نرمافزار را بلد باشید. هدف این است که از ربات برای ساخت بانک فایل مرتبط استفاده کنید.
اگر هنوز ربات را نصب نکردهاید، ابتدا راهنمای نصب ربات استخراج دیوار و اولین استخراج را بخوانید.
قبل از هر استخراج این جمله را کامل کنید: «من الان دنبال چه فایلهایی، برای کدام محدوده و برای چه هدفی هستم؟» اگر جواب مشخص نیست، احتمالاً فیلتر هنوز بیش از حد باز است.
چرا فیلتر مهمتر از تعداد آگهی است؟
فرض کنید دو مشاور داریم.
مشاور اول ۱۲۰۰ آگهی از کل شهر استخراج میکند.
مشاور دوم ۱۴۰ آگهی فقط از سه محله تخصصی خودش میگیرد.
در ظاهر نفر اول بانک فایل بزرگتری دارد.
اما اگر بیشتر مشتریهای او فقط در همان سه محله باشند، احتمالاً بخش بزرگی از ۱۲۰۰ ردیف هیچ استفاده روزمرهای ندارد.
| مدل استخراج | مزیت ظاهری | مشکل عملی |
|---|---|---|
| استخراج خیلی باز | تعداد فایل بالا | نویز، فایل نامرتبط، پاکسازی بیشتر |
| استخراج هدفمند | تعداد کمتر | فایل قابل استفادهتر و جستجوی سریعتر |
مشاور حرفهای قرار نیست بیشترین ردیف Excel را تولید کند.
قرار است دادهای جمع کند که بتواند سریعتر به تماس، بازدید، قیمتگذاری و مشتری متصل شود.
قبل از فیلتر کردن، هدف استخراج را مشخص کنید
برای هر بار اجرای ربات بهتر است یکی از این هدفها روشن باشد:
- پیدا کردن فایل تازه برای مشتری مشخص
- ساخت بانک فایل یک محله
- جستجوی فایل شخصی و مالک محتمل
- تحلیل قیمت یک بازار
- بهروزرسانی Dataset قبلی
- بررسی فایلهای جدید یک دسته خاص
هر هدف، فیلتر متفاوتی میخواهد.
اگر هدف تحلیل بازار است، شاید حجم بیشتری از فایلهای همرده لازم داشته باشید.
اگر مشتری مشخص دارید، بهتر است فیلتر محدودتر باشد.
یک فرمول ساده برای فیلتر حرفهای
میتوانید هر استخراج را با این شش سؤال طراحی کنید:
- کجا؟
- چه معاملهای؟
- چه نوع ملکی؟
- چه مقدار داده؟
- با چه ترتیب؟
- برای چه استفادهای؟
مثلاً:
«تهران، پاسداران و هروی، فروش آپارتمان، ۲۰۰ آگهی تازه، برای ساخت Dataset فروش این هفته.»
همین جمله، تنظیمات شما را تقریباً مشخص میکند.
فیلتر اول: استان
ساختار جغرافیایی استخراج از سطح استان شروع میشود.
در نگاه اول انتخاب استان ساده است، اما وقتی کاربران روی چند شهر یا بازار مختلف کار میکنند، تفکیک استان از همان ابتدا اهمیت بیشتری پیدا میکند.
اگر فقط روی یک شهر فعالیت دارید، معمولاً همان استان اصلی کافی است.
اگر آژانس شما در چند شهر فعالیت میکند، بهتر است خروجی هر استان و شهر در Datasetهای جدا نگهداری شود.
فیلتر دوم: شهر
بعد از استان، شهر را انتخاب میکنید.
اینجا یک تصمیم مهم وجود دارد:
آیا واقعاً کل شهر بازار شماست؟
برای بعضی شهرهای کوچک شاید بله.
اما در شهر بزرگی مثل تهران، استخراج کل شهر برای یک مشاور محلهای معمولاً ارزش کمی دارد.
اگر تخصص شما منطقه خاصی است، شهر فقط لایه اول محدودسازی است و محله اهمیت اصلی را دارد.
فیلتر سوم: محله؛ مهمترین فیلتر برای مشاور محلهای
برای بسیاری از مشاوران، محله مهمترین واحد بازار است.
قیمت، نوع ساختمان، متراژ غالب، رفتار مالک و حتی سرعت معامله میتواند بین دو محله نزدیک فرق کند.
به همین دلیل بهتر است خروجی را تا حد ممکن بر اساس بازار واقعی خودتان محدود کنید.
مثلاً به جای:
«فروش آپارتمان تهران»
از این مدل استفاده کنید:
«فروش آپارتمان پاسداران»
یا اگر چند محله همخانواده دارید:
«پاسداران + هروی + ضرابخانه»
این خروجی بعداً برای فایلینگ و تحلیل بسیار قابل فهمتر خواهد بود.
برای ساخت بانک فایل منطقهای، مقاله بانک فایل منطقهای املاک مکمل خوبی است.
آیا چند محله را همزمان انتخاب کنیم؟
بستگی دارد.
اگر چند محله واقعاً یک بازار کاری نزدیک برای شما هستند، ترکیب آنها منطقی است.
اما اگر فقط برای افزایش تعداد خروجی محلههای نامرتبط را اضافه میکنید، بهتر است جدا بمانند.
| وضعیت | پیشنهاد |
|---|---|
| سه محله نزدیک با مشتری مشترک | میتوانند در یک Workflow استخراج شوند |
| محلههای دور با قیمت و بازار متفاوت | Dataset جدا بهتر است |
| تحلیل قیمت | تا حد امکان محدوده همگنتر انتخاب شود |
| مشتری مشخص | فقط محلههای مورد قبول مشتری |
فیلتر چهارم: نوع معامله
یکی از مهمترین تفکیکها، نوع معامله است.
فروش و اجاره را بهتر است از ابتدا جدا نگه دارید.
چرا؟
چون منطق قیمت، فیلدهای موردنیاز، مشتری و تحلیل آنها متفاوت است.
برای مثال در فروش، قیمت کل و قیمت هر متر اهمیت بیشتری دارند.
در اجاره، رهن، اجاره ماهانه و شرایط تبدیل مهمتر میشوند.
اگر این دو را بیهدف با هم مخلوط کنید، خروجی بعداً نیازمند پاکسازی بیشتری خواهد بود.
فیلتر پنجم: نوع ملک
بعد از نوع معامله، نوع ملک را دقیق انتخاب کنید.
آپارتمان، خانه و ویلا، زمین، مغازه، دفتر کار و سایر دستهها بازار یکسانی ندارند.
اگر مشتری شما دنبال آپارتمان است، استخراج ویلا یا زمین فقط تعداد ردیف را بالا میبرد.
برای تحلیل بازار هم ترکیب انواع ملک میتواند آمار را گمراهکننده کند.
مثلاً مقایسه قیمت هر متر آپارتمان با زمین یا ویلای کلنگی در یک جدول، تحلیل قابل اتکایی ایجاد نمیکند.
سناریوی اول: رضا ۹۰۰ فایل گرفت ولی فقط ۶۰ مورد برایش مهم بود
رضا در مشهد روی دو محله مشخص کار میکند.
اولین بار که ربات را نصب میکند، کل شهر و چند نوع ملک را انتخاب میکند.
خروجی حدود ۹۰۰ ردیف میشود.
بعد دو ساعت وقت میگذارد تا فایلهای نامرتبط را حذف کند.
در استخراج بعدی تنظیم را تغییر میدهد:
- فقط دو محله اصلی
- فروش آپارتمان
- فایلهای تازه
خروجی ۱۴۰ ردیف میشود.
بعد از فیلتر قیمت و متراژ، حدود ۶۰ مورد برای بازار او قابل بررسیاند.
عدد ۱۴۰ از ۹۰۰ کوچکتر است، ولی برای کار روزانه ارزش بیشتری دارد.
تعداد آگهی را چطور انتخاب کنیم؟
عدد مناسب برای همه یکسان نیست.
سه عامل مهم دارید:
- هدف استخراج
- اندازه بازار
- تازگی موردنیاز
اگر فقط میخواهید فایلهای صبح امروز را بررسی کنید، شاید تعداد محدود کافی باشد.
اگر میخواهید Dataset تحلیلی یک محله بسازید، به نمونه بزرگتری نیاز دارید.
اگر تازه شروع کردهاید، با حجم کمتر شروع کنید و بعد افزایش دهید.
یک راهنمای ساده برای انتخاب تعداد
| هدف | رویکرد پیشنهادی |
|---|---|
| تست تنظیمات | حدود ۲۰ تا ۵۰ آگهی |
| فایلیابی روزانه یک محله | متناسب با حجم فایل تازه همان بازار |
| ساخت Dataset تحلیلی | نمونه بزرگتر و همگن |
| بهروزرسانی دورهای | تمرکز روی فایلهای تازه و Merge با داده قبلی |
به جای دنبال کردن یک عدد جادویی، خروجی را بر اساس هدف طراحی کنید.
مرتبسازی؛ فایل تازه یا ارزانتر؟
مرتبسازی خروجی باید با سؤال شما هماهنگ باشد.
اگر میخواهید فایلهای تازه را سریع پیدا کنید، جدیدترینها اهمیت بیشتری دارند.
اگر دنبال فایلهای پایینتر از بازار هستید، مرتبسازی قیمتی میتواند مرحله اولیه غربالگری باشد.
اگر میخواهید تصویر کلی بازار را بسازید، بهتر است فقط به یک سر طیف قیمت وابسته نباشید.
آیا ارزانترین فایل همیشه بهترین فایل است؟
نه.
قیمت پایین میتواند دلایل مختلف داشته باشد:
- سن بنا
- نبود پارکینگ
- طبقه نامناسب
- مشکل سند
- نیاز به بازسازی
- اشتباه در ثبت قیمت
بنابراین مرتبسازی از ارزان به گران فقط یک ابزار غربالگری است.
برای تشخیص فرصت واقعی، بعداً باید فایلهای مشابه و وضعیت بازار را هم بررسی کنید.
فیلتر فایل شخصی و مشاور چطور استفاده شود؟
اگر هدف اصلی شما فایلیابی مستقیمتر است، تفکیک احتمالی نوع آگهیدهنده میتواند مفید باشد.
اما این فیلتر را بهتر است «اولویت بررسی» ببینید، نه حقیقت قطعی.
مثلاً میتوانید فایلهای دارای احتمال شخصی بودن را اول تماس بگیرید.
بعد از تماس، نتیجه واقعی را در سیستم ثبت کنید.
این مدل بسیار بهتر از این است که فقط به برچسب سیستم اعتماد کنید.
سناریوی دوم: سارا دنبال مالک احتمالی است
سارا در اصفهان روی فایل شخصی تمرکز دارد.
روش قبلیاش این بود که هر آگهی را باز کند و از روی متن حدس بزند مالک است یا مشاور.
حالا Workflow او اینطور است:
- فقط دو محله تخصصی را استخراج میکند.
- فروش آپارتمان را انتخاب میکند.
- خروجی را در میز کار باز میکند.
- موارد شخصی یا مالک محتمل را جلوتر میآورد.
- با تماس کوتاه نتیجه را تأیید میکند.
ربات مالک را به جای او تشخیص نهایی نداده است.
فقط ترتیب بررسی ۲۰۰ فایل را منطقیتر کرده است.
فیلتر بر اساس مشتری بهتر است یا بازار؟
هر دو کاربرد دارند.
اگر مشتری مشخص دارید، از نیاز همان مشتری شروع کنید.
اگر بانک فایل عمومی میسازید، از بازار تخصصی خودتان شروع کنید.
مدل مشتریمحور
مثلاً مشتری میخواهد:
- فروش آپارتمان
- دو محله مشخص
- ۸۰ تا ۱۰۰ متر
- دوخواب
در این حالت ابتدا محدوده و دسته را در ربات محدود میکنید و بعد جزئیات بیشتر را در فایلینگ روی Dataset اعمال میکنید.
مدل بازارمحور
اگر تخصص شما یک محله است، ممکن است همه فایلهای فروش آپارتمان آن محله را دورهای بگیرید و بعد برای مشتریهای مختلف استفاده کنید.
چه فیلترهایی بهتر است بعد از استخراج انجام شوند؟
همه محدودسازیها لازم نیست در مرحله ربات انجام شوند.
بعضی فیلترها بهتر است بعد از Import در نمای آگهیهای میز کار اعمال شوند.
مثلاً:
- قیمت دقیق
- بازه متراژ
- برچسب
- علاقهمندی
- جستجوی متن
- ترکیب چند Dataset
پس ربات برای تعریف دامنه اصلی استخراج است و فایلینگ برای جستجوی دقیق داخل داده جمعآوریشده.
ربات و میز کار مکمل یکدیگرند
| مرحله | ابزار اصلی | مثال |
|---|---|---|
| دامنه بازار | ربات | تهران، پاسداران، فروش آپارتمان |
| جمعآوری داده | ربات | دریافت آگهیهای مرتبط |
| فیلتر دقیق | میز کار | ۹۰ تا ۱۱۰ متر، سقف بودجه مشخص |
| انتخاب فایل مهم | میز کار و مشاور | علاقهمندی، یادداشت و بررسی جزئیات |
| اتصال به مشتری | CRM | پیدا کردن مشتری مناسب برای فایل |
چطور خروجی چند محله را سازماندهی کنیم؟
اگر روی چند محله کار میکنید، از همان اول یک الگوی مشخص داشته باشید.
مثلاً:
- پاسداران — فروش آپارتمان
- هروی — فروش آپارتمان
- پاسداران — اجاره آپارتمان
- هروی — اجاره آپارتمان
این ساختار بعداً Compare، تحلیل و پیدا کردن فایل را بسیار سادهتر میکند.
مقاله سازماندهی آگهیهای دیوار درباره نظم دادن به بانک فایل توضیح بیشتری دارد.
یک Dataset بزرگ یا چند Dataset کوچک؟
این سؤال جواب مطلق ندارد.
اما برای بیشتر مشاورها، Datasetهای معنیدار بهتر از یک فایل بسیار بزرگ هستند.
مثلاً:
«فروش آپارتمان پاسداران — هفته اول مرداد»
از نظر کاربردی واضحتر از:
«همه فایلهای تهران تابستان»
است.
Dataset کوچکتر و مشخصتر:
- تحلیل راحتتری دارد.
- Compare دقیقتری میسازد.
- پاکسازی سادهتری دارد.
- منبع و زمان داده روشنتر است.
سناریوی سوم: نیما برای تحلیل قیمت اشتباه فیلتر کرده
نیما میخواهد قیمت هر متر یک محله را بررسی کند.
اما در خروجی خودش:
- آپارتمان
- خانه ویلایی
- زمین
- واحدهای بسیار کوچک
- فایلهای متراژ بالا
را کنار هم جمع کرده است.
میانگین قیمت خروجی برای تصمیم واقعی کاربرد کمی دارد.
در استخراج بعدی، فقط فروش آپارتمان را میگیرد و بعد در میز کار Comparableهای نزدیکتر را جدا میکند.
حالا تحلیل معنیدارتر شده است.
این مثال نشان میدهد فیلتر درست فقط برای فایلیابی نیست؛ کیفیت تحلیل را هم تعیین میکند.
فیلتر بیش از حد هم میتواند مشکل بسازد
همانطور که فیلتر خیلی باز مشکل دارد، فیلتر بیش از حد محدود هم میتواند نتیجه را ضعیف کند.
اگر آنقدر شرایط را محدود کنید که فقط دو فایل باقی بماند، شاید تصویر مناسبی از بازار نداشته باشید.
مثلاً برای تحلیل قیمت، بهتر است گروه Comparable به اندازه کافی نمونه داشته باشد.
برای مشتری هم گاهی یکی از ترجیحات قابل مذاکره است.
بنابراین باید فرق بین این دو را بدانید:
- شرط قطعی
- ترجیح
اگر مشتری میگوید پارکینگ حتماً لازم است، شرط است.
اگر تراس را فقط دوست دارد، شاید نباید کل بازار را به خاطر آن حذف کنید.
فیلتر مناسب برای فایلیابی روزانه
برای استفاده روزانه یک مشاور محلهای، مدل سادهای مثل این میتواند مناسب باشد:
- یک تا سه محله تخصصی
- یک نوع معامله
- یک نوع ملک
- مرتبسازی بر اساس تازگی
- تعداد متناسب با حجم روزانه بازار
- Import به Dataset همان روز یا هفته
بعد داخل میز کار، متراژ، قیمت و سایر جزئیات را روی مشتریهای فعال اعمال کنید.
فیلتر مناسب برای ساخت بانک فایل منطقهای
اگر هدف بانک فایل است، بهتر است تکرارپذیر باشید.
مثلاً هر شنبه:
- سه محله ثابت
- فروش آپارتمان
- تعداد مشخص
- نامگذاری بر اساس تاریخ
- Merge یا Compare با هفته قبل
بعد از چند ماه، فقط فایل روز ندارید؛ تاریخچه بازار دارید.
فیلتر مناسب برای مشتری داغ
اگر مشتری آماده بازدید است، دامنه را محدودتر کنید.
مثلاً مشتری:
- فقط دو محله
- فروش آپارتمان
- تا سقف بودجه مشخص
- پارکینگ ضروری
ابتدا بازار اصلی را با ربات جمع کنید و بعد در میز کار فقط گزینههای نزدیک را نگه دارید.
در این حالت هدف شما بانک فایل عمومی نیست؛ سرعت رسیدن به چند پیشنهاد مناسب است.
فیلتر مناسب برای تحلیل بازار
برای تحلیل بازار باید کمی متفاوت فکر کنید.
هدف صرفاً پیدا کردن فایل مشتری نیست.
باید نمونهای از بازار داشته باشید که تا حد ممکن همگن باشد.
مثلاً:
- یک محله مشخص
- فروش آپارتمان
- بازه متراژ قابل مقایسه
- حذف فایلهای پرت یا نامعتبر
بعد در میز کار میتوانید قیمت هر متر، میانه و توزیع قیمت را تحلیل کنید.
آیا باید همیشه جدیدترین آگهیها را بگیریم؟
برای فایلیابی روزانه معمولاً تازگی مهم است.
اما برای تحلیل، فقط جدیدترین چند فایل ممکن است کافی نباشند.
اگر میخواهید رفتار بازار را بفهمید، به Dataset بزرگتر و قابل مقایسه نیاز دارید.
پس حتی مرتبسازی هم باید تابع هدف باشد.
چرا خروجی بزرگتر همیشه تحلیل بهتر نمیدهد؟
فرض کنید ۲۰۰۰ آگهی دارید ولی نصف آنها از محلههای نامرتبط و انواع ملک متفاوتاند.
در مقابل ۳۰۰ آگهی تمیز و همگن دارید.
برای تحلیل یک بازار مشخص، Dataset دوم احتمالاً ارزش بیشتری دارد.
داده بیشتر وقتی مفید است که داده مرتبط باشد.
فیلتر ربات را با فیلتر Excel اشتباه نگیرید
ممکن است بگویید:
«همه چیز رو استخراج میکنم، بعد داخل Excel فیلتر میزنم.»
از نظر فنی شدنی است، ولی همیشه بهینه نیست.
اگر از ابتدا داده نامرتبط را نگیرید:
- زمان استخراج کمتر میشود.
- حجم فایل پایینتر میماند.
- پاکسازی سادهتر میشود.
- Dataset تمیزتری دارید.
فیلتر قبل از استخراج و فیلتر بعد از استخراج دو لایه مکملاند.
اشتباه اول: «همه چی رو بگیر»
این جمله معمولاً شروع یک بانک فایل شلوغ است.
اگر هدف مشخص ندارید، حجم بالا فقط کار بعدی را بیشتر میکند.
قبل از اجرا محدوده را محدود کنید.
اشتباه دوم: چند بازار متفاوت در یک خروجی
اگر فروش آپارتمان مرکز شهر را با ویلای حومه و مغازه تجاری در یک Dataset قرار دهید، فیلتر و تحلیل بعدی سختتر میشود.
Dataset باید یک معنی مشخص داشته باشد.
اشتباه سوم: استخراج تکراری بدون Merge
اگر هر هفته همان محدوده را استخراج میکنید ولی هیچ کنترل تکراری ندارید، بانک فایل به سرعت متورم میشود.
بعد از اینکه استخراج تکی را یاد گرفتید، استفاده از Merge و کنترل Token مرحله بعدی مهم است.
برای پاکسازی بعد از Import نیز مقاله حذف آگهی تکراری در فایلینگ کاربردی است.
اشتباه چهارم: انتخاب محله فقط بر اساس تعداد فایل
محلهای که ۵۰۰ آگهی دارد الزاماً بازار بهتری برای شما نیست.
اگر مشتری و تخصص شما در محدوده دیگری است، همان محدوده با ۱۲۰ فایل ارزش بیشتری دارد.
اشتباه پنجم: استفاده از فیلتر شخصی به عنوان حکم قطعی
هدف فیلتر نوع آگهیدهنده اولویتبندی است.
بعد از تماس ممکن است نتیجه تغییر کند.
سیستم باید کمک کند کجا زودتر بررسی کنید، نه اینکه جای ارتباط انسانی را بگیرد.
اشتباه ششم: نگه داشتن Dataset بدون تاریخ
اگر هر هفته خروجی میگیرید ولی اسم همه فایلها یکسان است، بعداً نمیدانید کدام مربوط به چه زمانی است.
تاریخ را وارد نام Dataset کنید.
مثلاً:
هروی — فروش آپارتمان — هفته چهارم مرداد ۱۴۰۵
یک چکلیست ۱۰ مرحلهای قبل از استخراج
- هدف استخراج را مشخص کن.
- استان را انتخاب کن.
- شهر را انتخاب کن.
- محله یا محلههای واقعی بازار خودت را مشخص کن.
- نوع معامله را جدا کن.
- نوع ملک را دقیق انتخاب کن.
- تعداد آگهی را متناسب با هدف تعیین کن.
- مرتبسازی را بر اساس تازگی یا قیمت انتخاب کن.
- بدان خروجی قرار است کجا استفاده شود.
- نام Dataset بعدی را از قبل مشخص کن.
اگر بعد از استخراج مجبور شدید بیش از نیمی از فایلها را فقط به خاطر محله، نوع معامله یا نوع ملک حذف کنید، احتمالاً فیلتر مرحله استخراج بیش از حد باز بوده است.
بعد از استخراج چه کنیم؟
بعد از گرفتن خروجی، مستقیم سراغ استخراج بعدی نروید.
اول کیفیت فایل را بررسی کنید.
- چند ردیف تصادفی را باز کنید.
- محدوده را بررسی کنید.
- نوع معامله را بررسی کنید.
- تعداد فایلهای نامرتبط را بسنجید.
- در صورت رضایت، فایل را وارد بخش Import میز کار کنید.
بعد میتوانید Dataset را در لیست Datasetها مدیریت کنید.
فیلتر خوب چطور به CRM کمک میکند؟
فرض کنید CRM شما سه مشتری فعال دارد.
اگر Dataset جدید شما مرتبط با محدوده و نوع معامله آنها باشد، پیدا کردن Match سادهتر میشود.
اما اگر خروجی شامل صدها فایل نامرتبط باشد، هم سیستم و هم مشاور باید نویز بیشتری را کنار بزنند.
برای همین کیفیت استخراج از همان ابتدا روی مرحله CRM اثر میگذارد.
اگر هنوز مشتریها را ساختاریافته ثبت نکردهاید، CRM املاک فایلینگ دیوار برای ثبت مخاطب، معامله و پیگیری در دسترس است.
یک Workflow پیشنهادی برای مشاور محلهای
| مرحله | اقدام |
|---|---|
| ۱ | انتخاب دو تا سه محله اصلی |
| ۲ | جداسازی فروش و اجاره |
| ۳ | استخراج فایلهای تازه |
| ۴ | Import در Dataset مشخص |
| ۵ | فیلتر دقیق قیمت و متراژ در میز کار |
| ۶ | بررسی مالک محتمل و تماس |
| ۷ | اتصال فایل مناسب به مشتری CRM |
| ۸ | بهروزرسانی دورهای و Compare |
چه زمانی باید فیلتر را تغییر دهیم؟
فیلتر قرار نیست برای همیشه ثابت بماند.
اگر مشتریهای شما تغییر کردند، بازار تغییر کرد یا تخصصتان محدودتر شد، تنظیمات هم باید تغییر کنند.
مثلاً اگر بیشتر تماسهای این ماه مربوط به واحدهای زیر ۱۰۰ متر هستند، شاید منطقی باشد Workflow فایلینگ روزانه را متناسبتر کنید.
اما بهتر است تغییر را بر اساس داده و نیاز واقعی انجام دهید، نه صرفاً حس لحظهای.
فیلتر خوب چه شکلی است؟
فیلتر خوب سه ویژگی دارد:
- به بازار واقعی شما نزدیک است.
- خروجی را بیش از حد کوچک نمیکند.
- بخش بزرگی از فایلهای کاملاً نامرتبط را از ابتدا حذف میکند.
هدف تعادل است.
نه «همه چیز» و نه «فقط یک فایل دقیق».
بعد از یادگیری فیلتر، قدم بعدی چیست؟
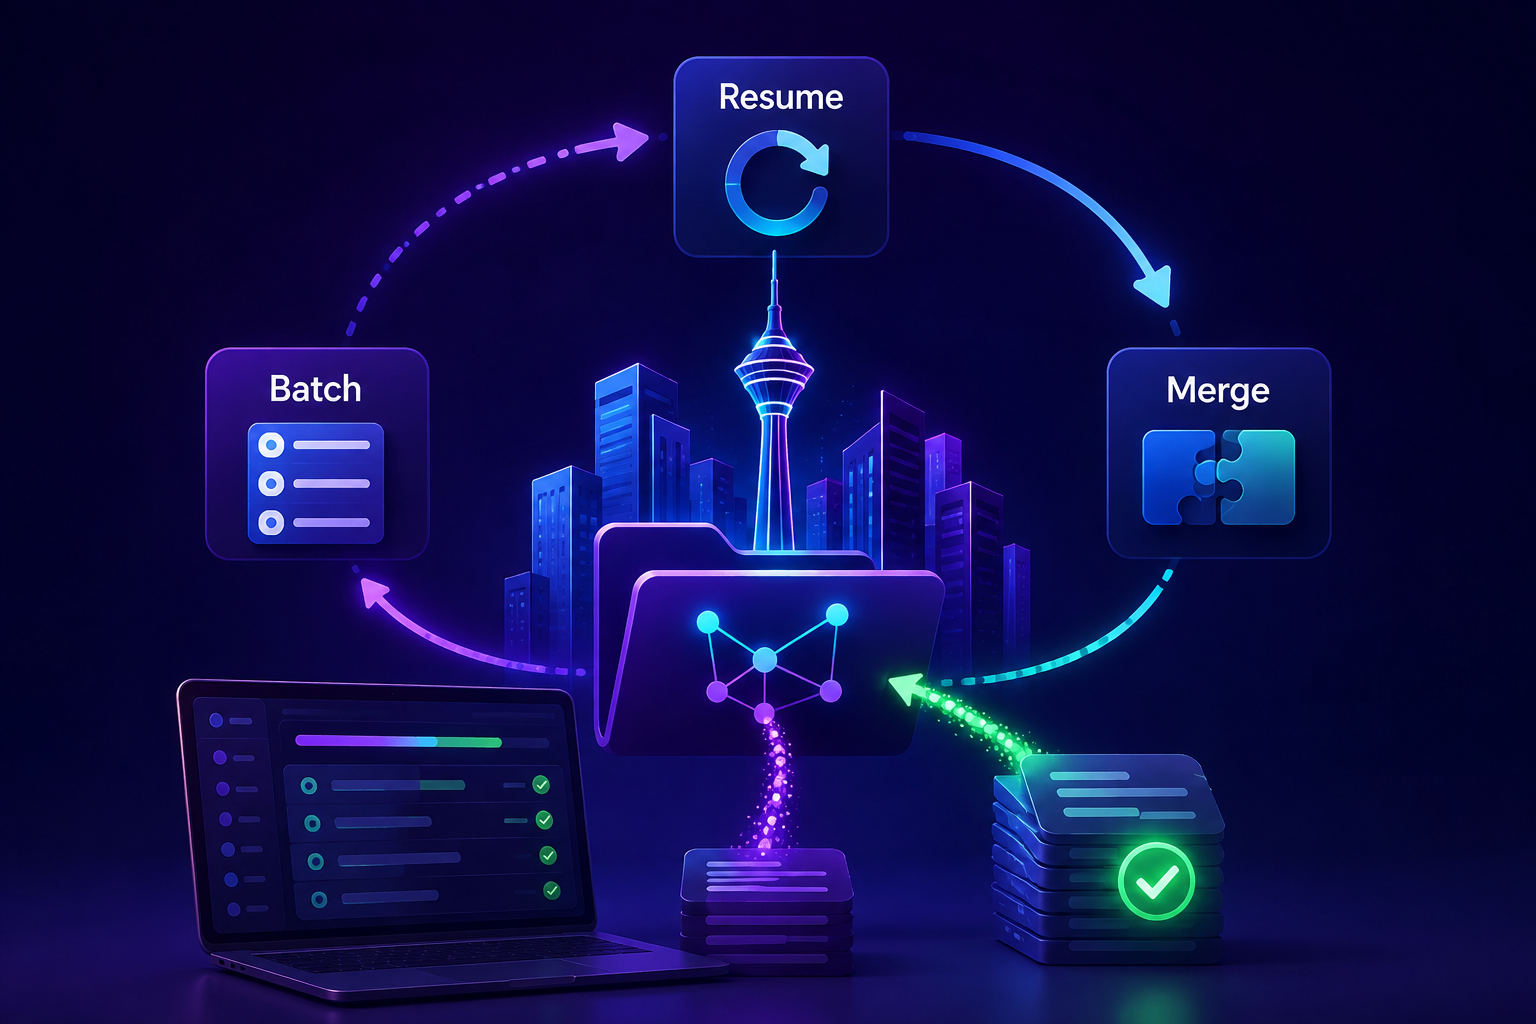
وقتی چند استخراج هدفمند انجام دادید، مرحله بعدی منطقی Batch، Resume و Merge است.
یعنی به جای اجرای دستی هر محله در هر بار، کارهای تکرارشونده را ساختاریافتهتر کنید و خروجیهای جدید را بدون تکرار به بانک فایل قبلی اضافه کنید.
این مرحله زمانی ارزش دارد که اول فیلترهایتان درست باشند.
اتوماسیون یک تنظیم اشتباه فقط همان اشتباه را سریعتر تکرار میکند.
جمعبندی؛ ربات را برای فایل بیشتر تنظیم نکنید، برای فایل درست تنظیم کنید
فیلتر ربات استخراج دیوار فقط چند منوی قبل از شروع نیست.
این بخش تعیین میکند دادهای که چند دقیقه بعد میگیرید چقدر برای کار واقعی شما قابل استفاده باشد.
قبل از استخراج:
- بازار را مشخص کنید.
- محله را محدود کنید.
- فروش و اجاره را جدا کنید.
- نوع ملک را دقیق انتخاب کنید.
- تعداد را بر اساس هدف تعیین کنید.
- مرتبسازی را آگاهانه انتخاب کنید.
- از قبل بدانید خروجی وارد کدام Dataset میشود.
اگر بعد از استخراج هنوز مجبورید صدها فایل کاملاً نامرتبط را کنار بزنید، مشکل از سرعت ربات نیست؛ فیلتر شما نیاز به اصلاح دارد.
برای شروع عملی، ربات دیوار را باز کنید و این بار فقط یک بازار واقعی خودتان را استخراج کنید.
بانک فایل حرفهای با فایل بیشتر ساخته نمیشود؛ با فایل مرتبطتر ساخته میشود.
سوالات متداول درباره فیلتر ربات استخراج دیوار
بهترین فیلتر برای ربات دیوار چیست؟
فیلتر واحدی برای همه وجود ندارد. بهتر است استان، شهر، محله، نوع معامله و نوع ملک را بر اساس بازار تخصصی یا مشتری واقعی خودتان محدود کنید و تعداد آگهی را متناسب با هدف استخراج انتخاب کنید.
آیا بهتر است کل شهر را استخراج کنیم؟
برای مشاور محلهای معمولاً نه. استخراج محدوده تخصصی باعث میشود خروجی مرتبطتر، فایلینگ سادهتر و تحلیل قابل فهمتری داشته باشید.
برای اولین استخراج چند آگهی مناسب است؟
برای تست تنظیمات حدود ۲۰ تا ۵۰ آگهی کافی است. بعد از بررسی کیفیت خروجی میتوانید تعداد را بر اساس بازار و هدف افزایش دهید.
فروش و اجاره را در یک فایل بگیریم یا جدا؟
در بیشتر Workflowهای حرفهای بهتر است فروش و اجاره جدا باشند، چون فیلدها، منطق قیمت، مشتری و تحلیل آنها متفاوت است.
آیا ربات میتواند فقط فایلهای شخصی را پیدا کند؟
سیستم میتواند برای نوع آگهیدهنده سرنخ یا اولویت ایجاد کند، اما بهتر است تشخیص شخصی یا مشاور به عنوان احتمال استفاده شود و نتیجه نهایی با تماس و بررسی انسانی تأیید شود.
فیلتر قیمت و متراژ را داخل ربات انجام دهیم یا میز کار؟
ربات برای محدود کردن دامنه اصلی بازار مناسب است و میز کار برای جستجو و فیلتر دقیقتر داخل Dataset کاربرد دارد. این دو مرحله مکمل یکدیگرند.
اگر خروجی خیلی بزرگ شد چه کنیم؟
ابتدا بررسی کنید آیا محلهها، نوع معامله یا نوع ملک بیش از حد باز انتخاب شدهاند. بهتر است به جای پاکسازی دائمی فایلهای نامرتبط، دامنه استخراج بعدی را دقیقتر کنید.
Dataset بزرگ بهتر است یا چند Dataset کوچک؟
برای بیشتر مشاورها Datasetهای معنادار بر اساس محله، معامله و تاریخ مدیریت سادهتری دارند. فایل بسیار بزرگ فقط زمانی مفید است که هدف مشخصی برای استفاده از آن داشته باشید.
بعد از فیلتر حرفهای چه قابلیتی را یاد بگیریم؟
بعد از تسلط بر استخراج تکی و فیلترها، Batch برای اجرای چند کار، Resume برای ادامه عملیات و Merge برای افزودن داده جدید بدون تکرار Tokenها قدمهای بعدی منطقی هستند.